自适应 K 与非负约束网络
这份笔记整理两个相关但不能混在一起的问题:
- 自适应网络如何找到有效维度
K? - NNC / nonnegative similarity matching 为什么会表现得像聚类或特征发现?
一句话先说结论:
自适应找
K主要是谱选择问题;NNC 的意义主要是把相似度结构压进非负的 activity slots,因此在有簇结构的数据上会自然表现成 soft clustering。
1. 两个 K 不是同一个东西
在 similarity matching 这条线里,K 至少有两种含义。
第一种是 adaptive dimensionality reduction 里的 K_eff:
输入协方差谱里有多少个方向足够强,网络就保留多少个有效输出维度。
这里的核心对象是输入协方差矩阵:
1 | C_x = E[x x.T] |
如果 C_x 的前几个 eigenvalues 很大,后面突然掉下去,那么一个带阈值的自适应网络就可以把高于阈值的方向保留下来,把低于阈值的方向关掉。这个 K_eff 是数据依赖的,不一定需要手动指定。
第二种是 NNC / NSM 里的 output slots 数量:
给网络几个非负输出单元,让它用这些单元解释样本之间的相似度。
如果数据天然有几个簇,这些非负单元就很容易变成 soft cluster membership。这个 K 更像“我给网络几个簇/特征槽位”。
所以更准确的区分是:
| 问题 | 更接近哪种 K | 网络在做什么 |
|---|---|---|
| 数据有几个重要变化方向? | K_eff |
谱阈值 / effective dimensionality selection |
| 数据能否被几个非负模式解释? | NNC slots | soft clustering / sparse feature discovery |
2. 自适应找 K:不是神秘地数簇,而是看谱
假设输入数据的协方差谱长这样:
1 | lambda_1, lambda_2, lambda_3, ..., lambda_D |
如果前几个 eigenvalues 明显大,说明输入里有几个强方向。它们可能对应总浓度、分子族、共同背景、或者某些 dominant chemical blocks。
自适应找 K 的最简单版本就是:
1 | K_eff = count(lambda_i > threshold) |
这听起来很朴素,但它有一个重要含义:
网络不需要预先知道“应该保留 6 个还是 7 个方向”。只要阈值和输入统计固定,活跃维度数会自动由数据谱决定。
更柔和一点的版本不是硬关掉,而是 soft threshold:
1 | lambda_y_i = max(lambda_x_i - theta, 0) |
这时强方向被保留但压缩,弱方向可能被压到接近 0。它不是完整 PCA whitening,而是带阈值的谱压缩。
3. 为什么这对嗅觉预处理有意义
ORN response 里常见的问题是:很多 ORN 一起动。
一起动的原因可能不是具体气味身份,而是:
- 总浓度变大;
- 某个分子族整体增强;
- 背景刺激共同影响很多 ORN;
- receptor sensitivity 矩阵太稠密,导致所有 ORN 都共享一个强轴。
这些共同轴会表现为 covariance spectrum 里的大 eigenvalues。
LC / adaptive SM 的价值就在这里:
它优先看见强共同方向,并通过 lateral feedback 把这些方向压小,让输出
y的谱更平。
所以 K 越大,经常越能去相关,不是因为它“删除了前 K 个 PCA component”,而是因为侧向通道更多,可以覆盖更多种共享模式。
但 K 不是越大越无脑好:
- 主导相关结构处理完以后,继续增加
K的收益会饱和; - 样本少时,过大的
K可能学到噪声; - 如果反馈过强,可能压掉任务相关信息;
- LC 是 partial whitening,不是精确 whitening。
4. NNC 的目标:保留样本之间的相似度
普通 similarity matching 的核心目标可以粗略写成:
1 | min_Y || X.T X - Y.T Y ||_F^2 |
意思是:
如果两个样本在输入里相似,那么输出里也应该相似;如果输入里不同,输出里也应该不同。
NNC / nonnegative similarity matching 加了非负约束:
1 | Y >= 0 |
这个约束很重要。没有非负约束时,输出单元可以正负抵消,更像线性子空间坐标。加了非负约束后,每个输出单元更像一个“存在量”:
- 某个 feature 出现了多少;
- 某个 odor family 被激活了多少;
- 某个 soft cluster membership 有多强。
这就是为什么 NNC 会自然连接到聚类和 sparse feature discovery。
5. 为什么 NNC 会像 k-means
如果数据有清楚的簇,同一簇内部样本彼此相似,不同簇之间相似度低,那么 X.T X 会出现块状结构:
1 | 同簇样本: high similarity |
NNC 要用非负输出 Y 重建这个相似度结构:
1 | Y.T Y ≈ X.T X |
最省力的做法是什么?
让同一簇的样本激活同一个输出单元。这样:
- 同簇样本因为共享输出单元,所以
Y.T Y大; - 异簇样本激活不同输出单元,所以
Y.T Y小。
这就很像 k-means。
但 NNC 和 k-means 不完全一样:
| k-means | NNC / NSM |
|---|---|
| 显式最小化点到中心的距离 | 匹配样本两两相似度 |
| 通常 hard assignment | 可以 soft assignment |
| 每个点主要属于一个中心 | 一个样本可以激活多个非负 feature |
| 更像几何聚类算法 | 更像神经活动的非负相似度分解 |
所以更安全的说法是:
NNC 在 well-segregated data 上会表现得像 soft k-means,但它本质上是在做非负相似度匹配。
6. 我跑的小实验
我新增了脚本:
1 | scripts/experiment_adaptive_k_nnc_research.py |
它做两个演示。
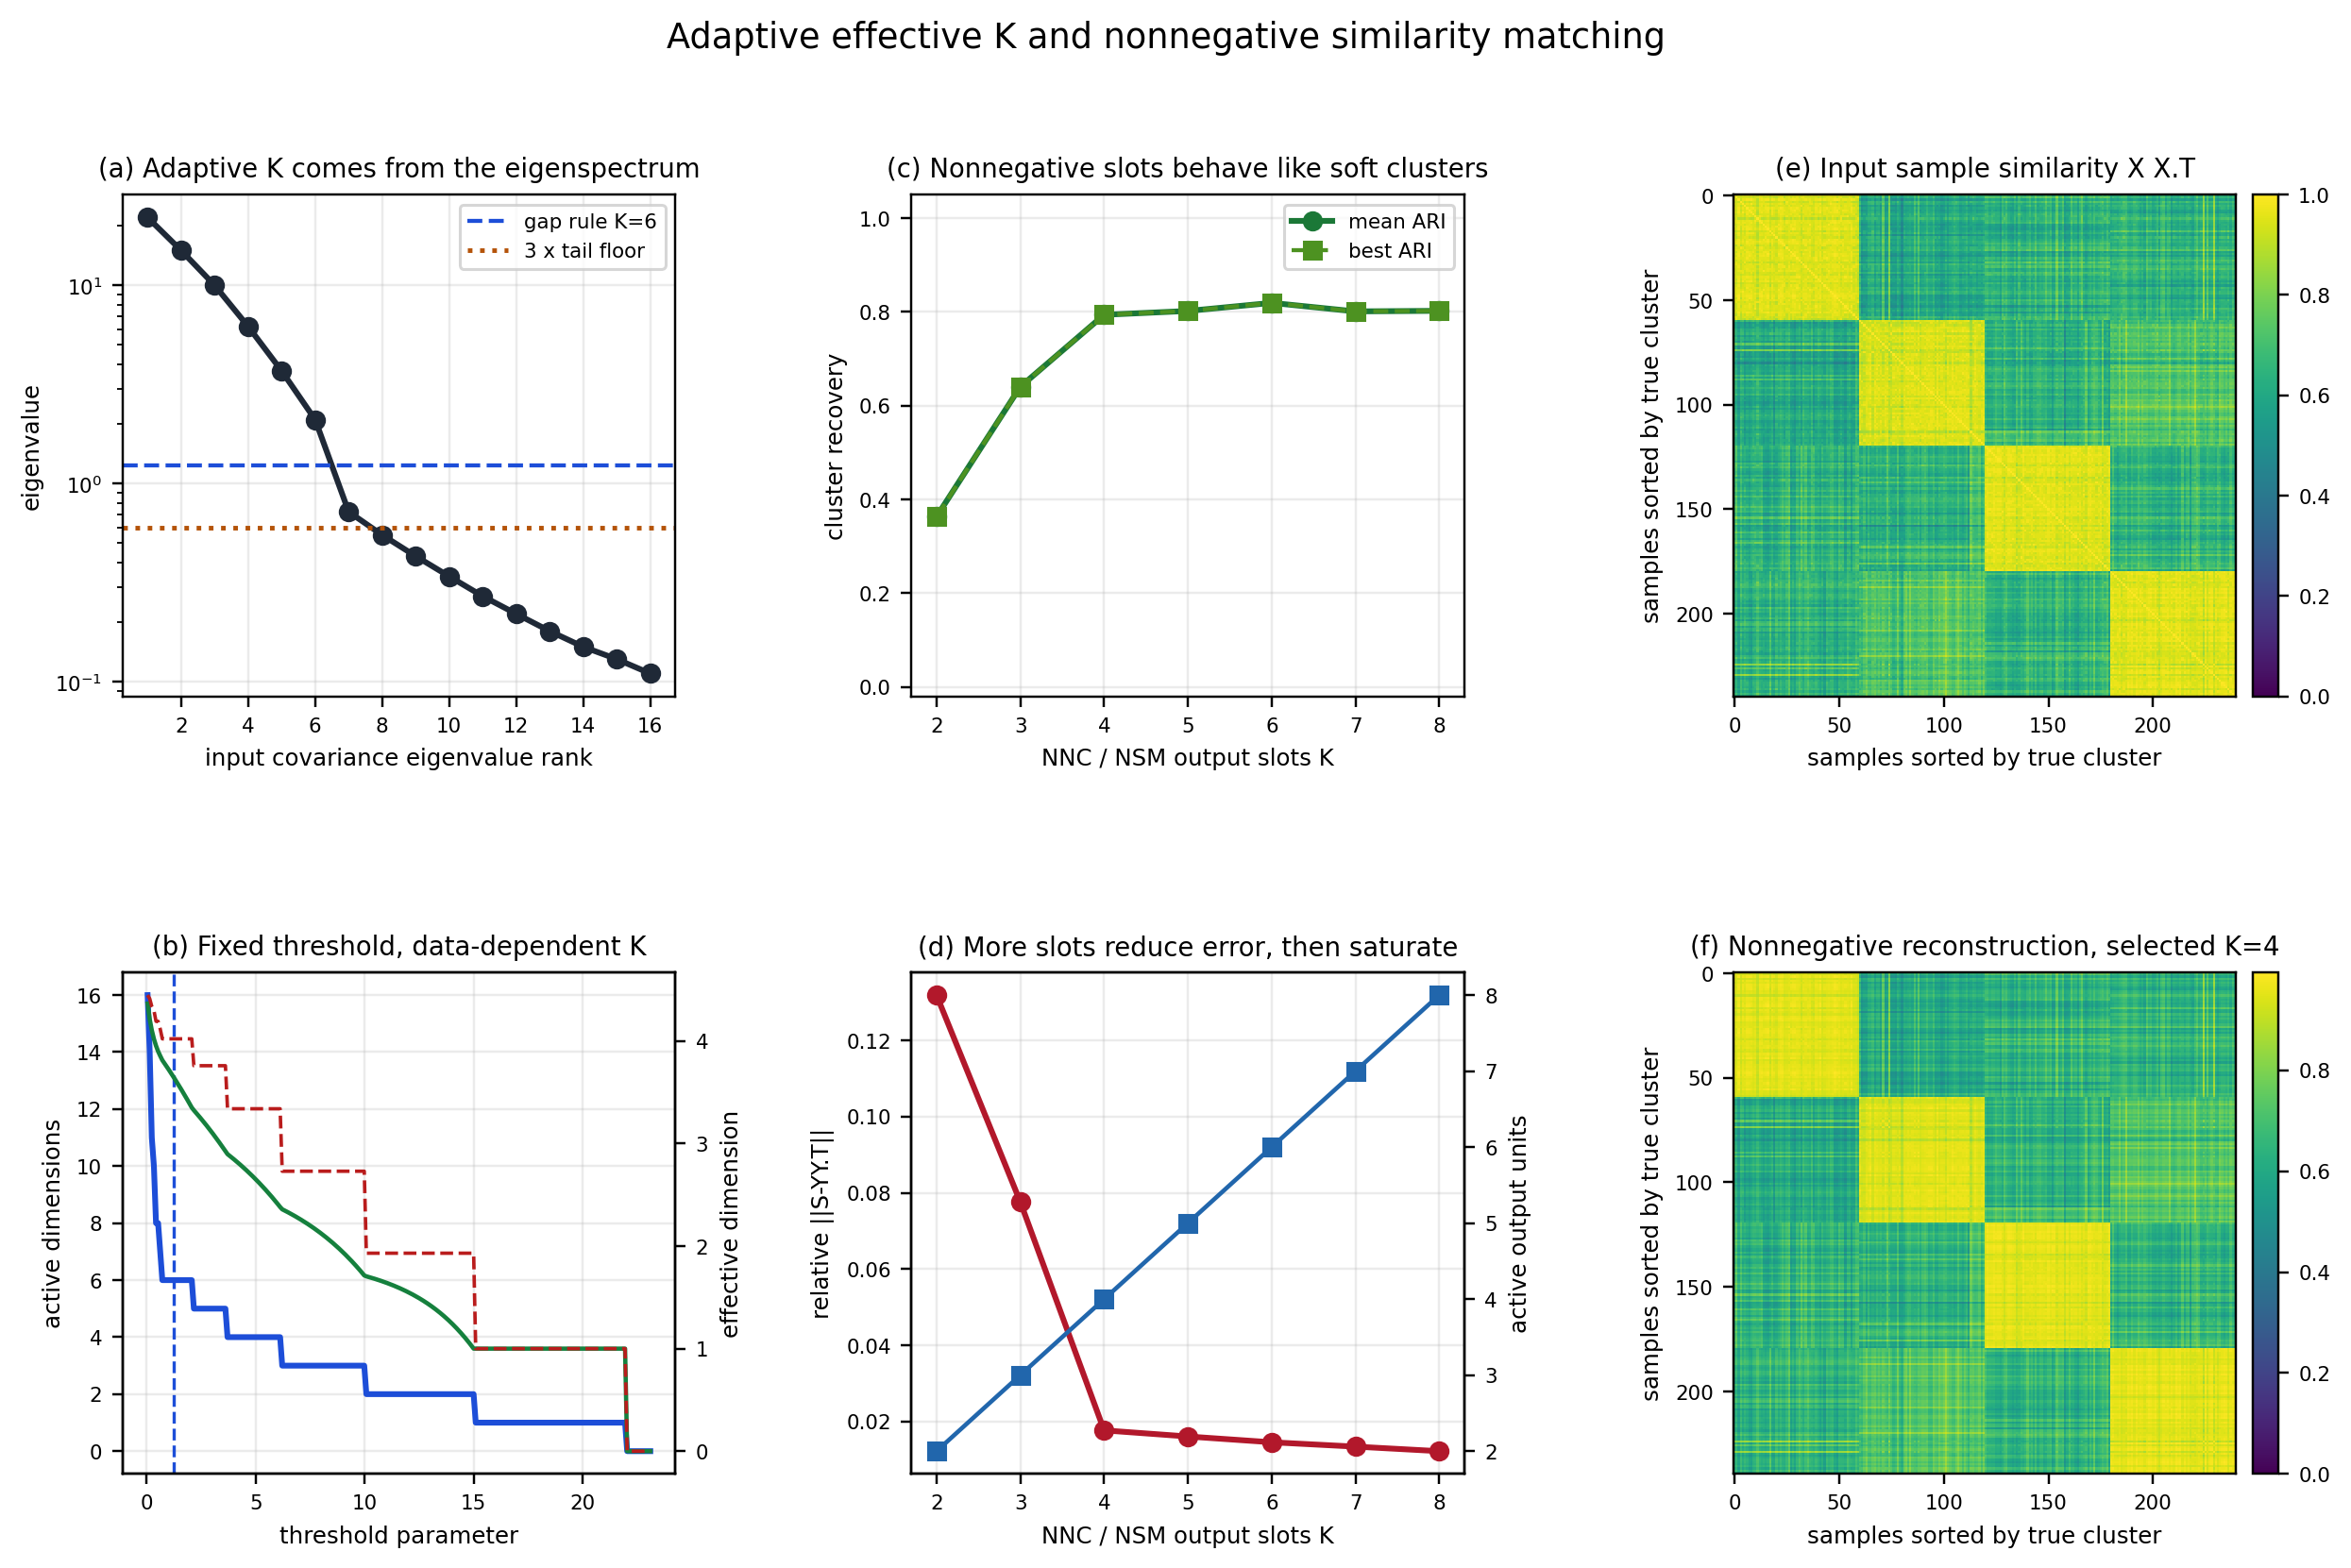
第一个演示:构造一个有明显谱断点的数据集,然后看不同 threshold 下有多少 active dimensions。结果显示,gap rule 给出 K=6,tail noise floor rule 给出 K=7。这说明自适应找 K 其实是在问:
哪些 covariance eigenvalues 足够大,值得作为有效维度保留?
第二个演示:构造 4 个正值簇,用非负相似度分解代理 NNC / NSM 的直觉。结果是:
| K | 相似度重建误差 | ARI |
|---|---|---|
| 2 | 0.132 | 0.363 |
| 3 | 0.078 | 0.640 |
| 4 | 0.018 | 0.794 |
| 5 | 0.016 | 0.802 |
| 6 | 0.015 | 0.819 |
| 7 | 0.013 | 0.801 |
| 8 | 0.012 | 0.802 |
解释:
K=2,3太小,几个真实簇被合并;K=4已经进入主要平台,说明非负槽位基本抓住了 4 个簇;K>4继续降低 reconstruction error,但更多是在分裂子结构,而不是发现全新的主簇。
图在这里:
7. 可以变成论文/网站里的核心表达
我建议之后这样写:
Adaptive similarity-matching networks provide a principled way to select an effective dimensionality from the input covariance spectrum. In contrast, nonnegative similarity matching gives the lateral population a different interpretation: each nonnegative activity dimension can act as a soft feature or cluster slot. Thus, adaptive LC-style circuits are naturally suited for spectral decorrelation and partial whitening, whereas NNC-style circuits connect the same similarity-matching principle to clustering and feature discovery.
中文可以写成:
自适应 SM/LC 主要回答“输入里有多少个值得保留或压缩的强统计方向”;NNC 则进一步回答“这些统计结构能否被几个非负的 feature / cluster 槽位解释”。前者更接近谱选择和 partial whitening,后者更接近 soft clustering 和 sparse feature discovery。
8. 下一步最值得做的实验
下一步不要只做 toy data。可以直接接到你的 olfactory synthetic data:
- 对 ORN
x的 covariance spectrum 做 threshold scan,估计K_eff。 - 对 LC 的不同
K画 spectrum flattening、mean offdiag corr、effective dimension。 - 对 NNC 的不同
K画zactivity heatmap,看它是否对应 odor family / molecular block。 - 用 ARI/NMI 比较 NNC active slots 和真实 block labels。
- 看
K从小到大时,是先恢复主簇,还是只是降低 similarity reconstruction error。
这样就能把“找 K”和“NNC 聚类意义”连接回你的嗅觉预处理主题。